Wo eigene KI-Grundlagenforschung zur schlüsselfertigen Industrie-Realität wird.
Software und Hardware sind nur so stark wie ihre Einbettung in Ihren Betrieb. Mit dem Explicio Campus begleiten unsere Ingenieure und KI-Forscher Ihr Unternehmen persönlich: von der strategischen Wissens-Inventur über gesetzlich anerkannte KI-Schulungen bis zur Entwicklung individueller Konnektoren für Ihre Anlagen, Prüfstände und Messreihen.
Gleichzeitig öffnen wir im Campus unsere eigene Forschungs-Werkstatt: Laden Sie unsere vollständigen Whitepaper zu reproduzierbaren GPU-Kernel-Entscheidungen und unseren eigenen pair4-Entscheidungsmodellen kostenfrei auf Deutsch und Englisch herunter.
Von der Wissens-Architektur über KI-Schulungen (EU AI Act Art. 4) und individuelle Anlagen-Konnektoren bis zu unseren publizierten KI-Whitepapern aus Detmold.
WHITEPAPER & FORSCHUNGSBERICHTE · GEMESSEN AUF ECHTER HARDWARE
Jede Zahl hat eine Rohdatei. Lesen Sie unsere Forschungsberichte im Original.
Warum kippen große Sprachmodelle trotz temperature=0? Und warum schlägt unser kleiner, auf der CPU laufender Encoder mit 307 Millionen Parametern große 35-Milliarden-Parameter-Modelle bei der Vorab-Entscheidung? Hier sind unsere Messungen, Methoden und Grenzen – offen auf Deutsch und Englisch dokumentiert.
WHITEPAPER #01 · STAND 20. SEPTEMBER 2026 · 15 SEITEN · AUTOR: CHRISTIAN THIEDE (ORCID 0009-0002-4517-7208)
Reproduzierbare Entscheidungen auf nicht bitstabiler Hardware
Entscheidungen einer KI-Wissensverwaltung gegen das Rauschen des Inferenzkernels absichern (Messungen auf NVIDIA GB10, vLLM 0.24.0, Qwen3.6-35B-A3B-NVFP4).
Das gemessene Problem: Zwanzig identische Aufrufe bei temperature=0 auf einem leeren Server liefern 17 verschiedene Texte. Ursache ist kein Server-Schalter, sondern der NVFP4-Marlin-Rechenkern im Expertenblock ab Schicht 0 (54 von 3,85 Mio. Tensor-Elementen weichen minimal ab).
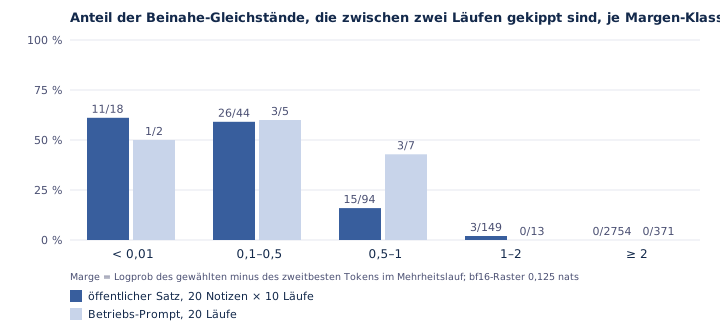
Die 2-nats-Gesetzmäßigkeit: Unsere Logprob-Sonde beweist über 5.478 gemessene Token-Positionen: Entscheidungen kippen ausschließlich bei Beinahe-Gleichständen. Liegt die Marge zwischen dem besten und zweitbesten Token über 2 nats, kippt in 0 von 5.478 Positionen ein einziges Ergebnis.
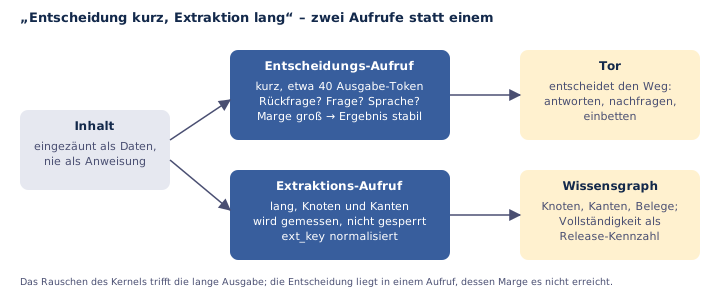
Die Explicio-Lösung: Durch das Architekturmuster „Entscheidung kurz (~40 Token), Extraktion lang“ verlegen wir geschäftskritische Entscheidungen (Rückfrage? Frage? Sprache?) dorthin, wo die Marge groß ist – mit 8 von 8 stabilen Betriebsfällen ohne den 7,4-fachen Zeitverlust dichter Modelle.
Eingebettete Abbildungen
Figure 2: Anteil der Beinahe-Gleichstände, die zwischen zwei Läufen gekippt sind, je Margen-Klasse (nats)Figure 4: „Entscheidung kurz, Extraktion lang“ – zwei Aufrufe statt einem
WHITEPAPER #02 · STAND 06. OKTOBER 2026 · 17 SEITEN · AUTOR: CHRISTIAN THIEDE (ORCID 0009-0002-4517-7208)
Klein, kalibriert, nachprüfbar – Werkstattbericht zu Explicio pair4
Wie Explicio seine mehrsprachigen Entscheidungsmodelle für Absicht, Ja/Nein-Lesart und Folgefragen selbst entwickelt und auf der Box-CPU betreibt.
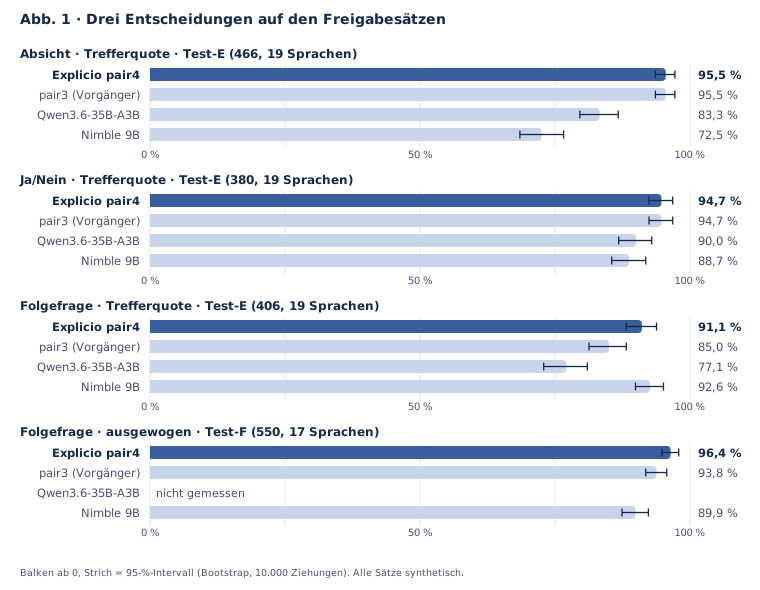
Warum vor jeder Suche 3 Entscheidungen fallen: Klassische Wortlisten treffen bei umgangssprachlichen Ja/Nein-Antworten („passt schon“) nur 34,5 % und bei Folgefragen nur 57,6 %. Unser eigenes Modell pair4 (307M Parameter auf mmBERT-base, MIT-Lizenz) erreicht 95,5 % bei der Absicht, 94,7 % bei Ja/Nein und 96,4 % ausgewogene Trefferquote bei Folgefragen (Test-F).
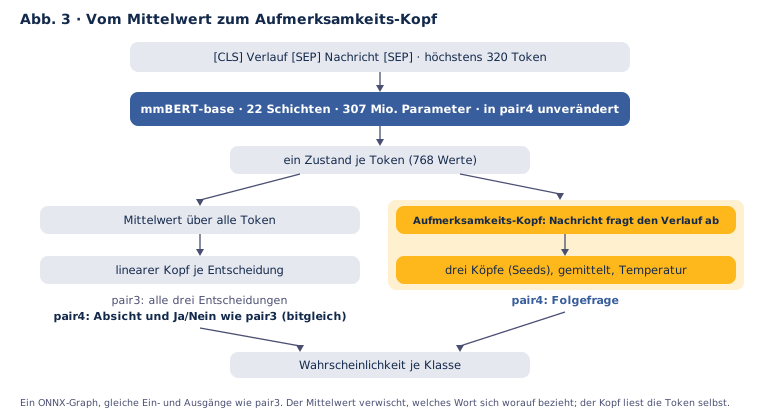
Die technische Innovation (Aufmerksamkeits-Kopf statt Mittelwert): Ein neu entwickelter 0,89M-Parameter-Aufmerksamkeits-Kopf liest die Token-Bezüge zwischen Verlauf und Nachricht direkt aus dem eingefrorenen Encoder ab und schließt 83 % der Lücke zu einem voll trainierten Modell – während Absicht und Ja/Nein über 3.700 Fälle bitgleich (Δp = 0) bleiben.
Tempo & nachgewiesene Sicherheit: pair4 rechnet in 62,8 ms (p95) auf 2 CPU-Fäden der Explicio Box (nur 1.526 MiB RAM, 0 MB GPU-Speicher) und besitzt eine statistisch nachgewiesene Fehlerschranke von 4,8 % bei 95 % Sicherheit (95,3 % Abdeckung). Trainiert zu 100 % ohne Kundendaten.
Eingebettete Abbildungen
Abb. 1: Drei Entscheidungen auf den Freigabesätzen (Explicio pair4 vs. pair3 vs. Qwen3.6-35B-A3B vs. Nimble 9B)Abb. 3: Vom Mittelwert zum Aufmerksamkeits-Kopf
WISSENSCHAFTLICHE EHRLICHKEIT · CHECKLISTE FÜR ENTSCHEIDER
Fünf Fragen, die Sie jedem Anbieter eines Wissensassistenten stellen sollten – auch uns.
01Welche Entscheidungen fallen vor der Suche – und wer trifft sie?Eine starre Wortliste (34,5 % Trefferquote), ein teures Sprachmodell (83,3 %) oder ein eigens kalibriertes Modell wie pair4 (95,5 % / 96,4 %)?
02Auf welchen Sätzen ist gemessen – und wie oft hat das Modell sie gesehen?Eine Erfolgszahl auf einem Testsatz, der beim Entwickeln mitgelesen wurde, ist wertlos. Bei Explicio sieht jedes Modell die Blind-Freigabesätze (Test-E und Test-F) genau ein einziges Mal.
03Gibt es eine statistisch nachgewiesene Fehlergrenze – und was passiert darunter?Ein Modell, das seine eigene Unsicherheit nicht kennt, kann sie nicht abgeben. pair4 arbeitet mit einer statistisch nachgewiesenen Schranke (< 4,8 % Fehler bei 95 % Sicherheit) und fragt im Zweifel den Menschen.
04Wo rechnet die Entscheidung – und was kostet sie?Blockiert jede Vorab-Prüfung eine GPU (151 bis 524 ms) oder läuft sie in 62,8 ms deterministisch auf der lokalen CPU, damit die GPU frei für die Antworten bleibt?
05Wo ist ein anderes Modell besser?„Ein Vergleich, der das nicht sagt, ist eine Anzeige.“ Deshalb dokumentieren wir in unseren Whitepapern jede Grenze und jeden Punkt, an dem Drittmodelle auf Einzelsätzen vorn lagen.
AUSBLICK · LAUFENDE FORSCHUNGExplicio pair5 (Ziel: < 40 ms für alle 3 Entscheidungen auf CPU, Mikrosekunden-Kaskade & Task-Adapter)
EXPLICIO® CAMPUS · THESEN & FORSCHUNG
Explicio® Campus: Wo Wissenschaft zur Industrie-Realität wird.
Wir glauben an die enge Verzahnung von Forschung und industrieller Anwendung. Kooperationen mit Hochschulen und Lehrstühlen bauen wir gerade auf – Sie müssen darauf nicht warten: Schreiben Sie uns, wir prüfen, ob es passt.
ABSCHLUSSARBEITENOffene Betreuung von AbschlussarbeitenPraxisnahe Bachelor- und Masterarbeiten, Dissertationen sowie forschungsnahe Studienarbeiten zu Wissensextraktion aus Sprache, Video und Dokumenten, hybridem Retrieval und Belegketten, Edge-KI auf kompakter Hardware und dezentraler Rechen-Infrastruktur.
RECHENZEITGPU-Rechenzeit im EinzelfallForschungsarbeiten scheitern oft an fehlender Rechenleistung. Für passende Projekte stellen wir Rechenzeit auf unseren GPU-Boxen zur Verfügung – im Einzelfall, nach Absprache, außerhalb der Betriebsfenster.
SPARRINGExperten-Sparring & SeminareUnser Team gibt Gastvorträge, leitet Fachseminare und unterstützt methodisch bei der Konzeption von Ontologien, Retrieval-Pipelines und Auswertungen.
DATENReale Fragestellungen statt Toy-DatensätzeForschen Sie an echten Fragestellungen des europäischen Mittelstands – Industriedaten nur mit ausdrücklicher Freigabe des jeweiligen Kunden und unter Wahrung von Datenschutz und Datensouveränität.